Search
moon
sun
🦾

Policy Gradient Algorithm

생성일
2024/08/05 02:59
최종 수정일
2026/04/07 00:46
태그
강화학습
작성자

1. Introduction

•
The Policy Gradient Algorithm optimizes a policy distribution by updating network parameters
◦
Applicable even to continous action space(with few restirctions on the action space)
•
Unlike DQN, when input states are given, the network outputs a probability distribution over possible actions based on parameter θ\theta
◦
From this distribution, an action is stochastically selected
•
The model is trained to maximize the expected return

2. Policy Gradient computation

•
Objective Function
◦
The expected return itself is used as the objective function
◦
J(θ)=Eτ∼pθ(τ)[∑t=0T−1γtr(st,at)]J(\theta)=E_{\tau \sim p_\theta(\tau)} [\sum^{T-1} _{t=0}\gamma^t r(s_t, a_t)]
▪
r(st,at)r(s_t, a_t) : Reward
▪
γ\gamma : Discount factor
▪
τ=(s0,a0,s1,a1,…,sT)\tau = (s_0,a_0,s_1,a_1, … , s_T) : Trajectory generated by policy π\pi
▪
pθ(τ)p_{\theta}(\tau) : The PDF of the trajectory generated by the policy π\pi
•
The policy is parameterized by θ\theta
•
pθ(τ)p_\theta (\tau) expansion
pθ(τ)=pθ(s0,a0,s1,a1,…,sT)=p(s0)⋅pθ(a0,s1,…,sT∣s0)=p(s0)⋅pθ(a0∣s0)pθ(s1,…,sT∣s0,a0)=p(s0)⋅pθ(a0∣s0)p(s1∣s0,a0)pθ(a1∣s0,a0,s1)pθ(s2,…,sT∣s0,a0,s1,a1) ⋮\begin{aligned} p_\theta(\tau) &= p_\theta(s_0, a_0, s_1, a_1, \ldots, s_T) \\ &= p(s_0) \cdot p_\theta(a_0, s_1, \ldots, s_T \mid s_0) \\ &= p(s_0) \cdot p_\theta(a_0 \mid s_0) p_\theta(s_1, \ldots, s_T \mid s_0, a_0) \\ &= p(s_0) \cdot p_\theta(a_0 \mid s_0) p(s_1 \mid s_0, a_0) p_\theta(a_1 \mid s_0, a_0, s_1) p_\theta(s_2, \ldots, s_T \mid s_0, a_0, s_1, a_1) \\ &\ \vdots \end{aligned}
•
transition probability is independent of the policy → Delete index θ\theta
◦
pθ(s1,…,sT∣s0,a0) →p(s1,…,sT∣s0,a0)p_\theta(s_1, \ldots, s_T \mid s_0, a_0) \ \rightarrow p(s_1, \ldots, s_T \mid s_0, a_0)
•
By the Markov property
◦
pθ(a1∣s0,a0,s1) =πθ(a1∣s1)p_\theta(a_1 \mid s_0, a_0, s_1) \ = \pi_\theta (a_1 |s_1)
◦
p(s2∣s0,a0,s1,a1)=p(s2∣s1,a1)p(s_2 | s_0, a_0, s_1, a_1) = p(s_2|s_1,a_1)
∴pθ(τ)=p(s0)∏t=0T−1πθ(at∣st)⋅p(st+1∣st,at) \therefore p_{\theta}(\tau) = p(s_0) \prod_{t=0}^{T-1} \pi_{\theta}(a_t \mid s_t) \cdot p(s_{t+1} \mid s_t, a_t)
•
Express the objective function using the state-value function.
◦
Express J(θ)=Eτ∼pθ(τ)[∑t=0T−1γtr(st,at)]J(\theta)=E_{\tau \sim p_\theta(\tau)} [\sum^{T-1} _{t=0}\gamma^t r(s_t, a_t)] using the definition of expectation
▪
τ=(s0,a0,…,sT)=(s0)∪τa0:sT\tau = (s_0, a_0, \dots, s_T) = (s_0) \cup \tau_{a_0:s_T}
▪
pθ(τ)=pθ(s0,τa0:sT)=p(s0)pθ(τa0:sT∣s0)p_{\theta}(\tau) = p_{\theta}(s_0, \tau_{a_0 :s_T}) = p(s_0) p_{\theta}(\tau_{a_0:s_T} \mid s_0)
J(θ)=∫τpθ(τ)(∑t=0T−1γtr(st,at))dτ=∫s0∫τa0:sTp(s0)pθ(τa0:sT∣s0)(∑t=0T−1γtr(st,at))dτa0:sT ds0=∫s0p(s0)[∫τa0:sTpθ(τa0:sT∣s0)(∑t=0T−1γtr(st,at))dτa0:sT]ds0=∫s0p(s0) Vπθ(s0) ds0=Es0∼p(s0)[Vπθ(s0)]J(\theta) = \int_{\tau} p_{\theta}(\tau) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) d\tau \\ = \int_{s_0} \int_{\tau_{a_0:s_T}} p(s_0) p_{\theta}(\tau_{a_0:s_T} \mid s_0) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) d\tau_{a_0:s_T} \, ds_0 \\= \int_{s_0} p(s_0) \left[ \int_{\tau_{a_0:s_T}} p_{\theta}(\tau_{a_0:s_T} \mid s_0) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) d\tau_{a_0:s_T} \right] ds_0\\ = \int_{s_0} p(s_0) \, V_{\pi_{\theta}}(s_0) \, ds_0 = \mathbb{E}_{s_0 \sim p(s_0)} \left[ V_{\pi_{\theta}}(s_0) \right]
•
Express ∇θ pθ(τ)\nabla_\theta \ p_\theta (\tau) using logarithmic differentiation
◦
∇θpθ(τ)=pθ(τ)∇θlog⁡pθ(τ)(logarithmic differentiation)\nabla_{\theta} p_{\theta}(\tau) = p_{\theta}(\tau) \nabla_{\theta} \log p_{\theta}(\tau) \quad \text{(logarithmic differentiation)}
∇θlog⁡pθ(τ)=∇θlog⁡(p(s0)∏t=0T−1πθ(at∣st)p(st+1∣st,at))=∇θ(log⁡p(s0)+∑t=0T−1(log⁡πθ(at∣st)+log⁡p(st+1∣st,at))=∑t=0T−1∇θlog⁡πθ(at∣st)\nabla_{\theta} \log p_{\theta}(\tau) = \nabla_{\theta} \log \left( p(s_0) \prod_{t=0}^{T-1} \pi_{\theta}(a_t \mid s_t) p(s_{t+1} \mid s_t, a_t) \right) \\ = \nabla_{\theta}( \log p(s_0) + \sum_{t=0}^{T-1} \left( \log \pi_{\theta}(a_t \mid s_t) + \log p(s_{t+1} \mid s_t, a_t) \right) \\ \\ = \sum_{t=0}^{T-1} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t)
•
∇θJ(θ)\nabla_\theta J(\theta)
∇θJ(θ)=∇θ∫τpθ(τ)(∑t=0T−1γtr(st,at))dτ=∫τ∇θpθ(τ)(∑t=0T−1γtr(st,at))dτ=∫τpθ(τ)∇θlog⁡pθ(τ)(∑t=0T−1γtr(st,at))dτ=∫τpθ(τ)(∑t=0T−1∇θlog⁡πθ(at∣st))(∑t=0T−1γtr(st,at))dτ=Eτ∼pθ(τ)[(∑t=0T−1∇θlog⁡πθ(at∣st))(∑t=0T−1γtr(st,at))] \nabla_{\theta} J(\theta) = \nabla_{\theta} \int_{\tau} p_{\theta}(\tau) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) d\tau \\ = \int_{\tau} \nabla_{\theta} p_{\theta}(\tau) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) d\tau \\ = \int_{\tau} p_{\theta}(\tau) \nabla_{\theta} \log p_{\theta}(\tau) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) d\tau \\ = \int_{\tau} p_{\theta}(\tau) \left( \sum_{t=0}^{T-1} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \right) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) d\tau \\ = \mathbb{E}_{\tau \sim p_{\theta}(\tau)} \left[ \left( \sum_{t=0}^{T-1} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \right) \left( \sum_{t=0}^{T-1} \gamma^t r(s_t, a_t) \right) \right]
•
Adjust the reward to be consistent with its definition.
Eτ∼pθ(τ)[∑t=0T−1(∇θlog⁡πθ(at∣st))(∑k=tT−1γkr(sk,ak))]=Eτ∼pθ(τ)[∑t=0T−1(∇θlog⁡πθ(at∣st))(∑k=tT−1γk−tγtr(sk,ak))]=Eτ∼pθ(τ)[∑t=0T−1(γt∇θlog⁡πθ(at∣st))(∑k=tT−1γk−tr(sk,ak))]≈Eτ∼pθ(τ)[∑t=0T−1(∇θlog⁡πθ(at∣st)(∑k=tT−1γk−tr(sk,ak)))]\mathbb{E}_{\tau \sim p_{\theta}(\tau)} \left[ \sum_{t=0}^{T-1} \left( \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \right) \left( \sum_{k=t}^{T-1} \gamma^{k} r(s_k, a_k) \right) \right] \\ = \mathbb{E}_{\tau \sim p_{\theta}(\tau)} \left[ \sum_{t=0}^{T-1} \left( \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \right) \left( \sum_{k=t}^{T-1} \gamma^{k-t} \gamma^{t} r(s_k, a_k) \right) \right]\\ = \mathbb{E}_{\tau \sim p_{\theta}(\tau)} \left[ \sum_{t=0}^{T-1} \left( \gamma^{t} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \right) \left( \sum_{k=t}^{T-1} \gamma^{k-t} r(s_k, a_k) \right) \right] \\ \approx \mathbb{E}_{\tau \sim p_\theta(\tau)} \left[ \sum_{t=0}^{T-1} \left( \nabla_\theta \log \pi_\theta (a_t | s_t) \left( \sum_{k=t}^{T-1} \gamma^{k-t} r(s_k, a_k) \right) \right) \right]
•
Update θ\theta using gradient ascent
◦
θ←θ+α∇θJ(θ)\theta ← \theta + \alpha \nabla_\theta J(\theta)
•
Introduce the Action value function
◦
τ=τs0:at∪τst+1:sT\tau = \tau_{s_0 : a_t} \cup \tau_{s_{t+1} : s_T}
∇θJ(θ)=∑t=0T−1Eτ∼pθ(τ)[γt∇θlog⁡πθ(at∣st)(∑k=tT−1γk−tr(sk,ak))]=∑t=0T−1∫τs0:at∫τst+1:sT(γt∇θlog⁡πθ(at∣st)(∑k=tT−1γk−tr(sk,ak)))pθ(τst+1:sT∣τs0:at)pθ(τs0:at) dτst+1:sT dτs0:at=∑t=0T−1∫τs0:atγt∇θlog⁡πθ(at∣st)[∫τst+1:sT(∑k=tT−1γk−tr(sk,ak))pθ(τst+1:sT∣τs0:at) dτst+1:sT]pθ(τs0:at) dτs0:at{\small \begin{aligned} \nabla_{\theta} J(\theta) &= \sum_{t=0}^{T-1} \mathbb{E}_{\tau \sim p_{\theta}(\tau)} \left[ \gamma^{t} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \left( \sum_{k=t}^{T-1} \gamma^{k-t} r(s_k, a_k) \right) \right] \\ &= \sum_{t=0}^{T-1} \int_{\tau_{s_0 : a_t}} \int_{\tau_{s_{t+1} : s_T}} \left( \gamma^{t} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \left( \sum_{k=t}^{T-1} \gamma^{k-t} r(s_k, a_k) \right) \right) p_{\theta}(\tau_{s_{t+1} : s_T} \mid \tau_{s_0 : a_t}) p_{\theta}(\tau_{s_0 : a_t}) \, d\tau_{s_{t+1} : s_T} \, d\tau_{s_0 : a_t} \\ &= \sum_{t=0}^{T-1} \int_{\tau_{s_0 : a_t}} \gamma^{t} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \left[ \int_{\tau_{s_{t+1} : s_T}} \left( \sum_{k=t}^{T-1} \gamma^{k-t} r(s_k, a_k) \right) p_{\theta}(\tau_{s_{t+1} : s_T} \mid \tau_{s_0 : a_t}) \, d\tau_{s_{t+1} : s_T} \right] p_{\theta}(\tau_{s_0 : a_t}) \, d\tau_{s_0 : a_t} \end{aligned} }
◦
pθ(τst+1:sT∣τs0:at)→pθ(τst+1:sT∣st,at)p_\theta (\tau_{s_{t+1} : s_{T}} | \tau_{s_0 : a_t}) \rightarrow p_\theta (\tau_{s_{t+1} : s_T} | s_t, a_t) : Markov property
◦
∫τst+1:sT(∑k=tT−1γk−tr(sk,ak))pθ(τst+1:sT∣st,at) dτst+1:sT=Qπθ(st,at)\int_{\tau_{s_{t+1} : s_T}} \left( \sum_{k=t}^{T-1} \gamma^{k-t} r(s_k, a_k) \right) p_{\theta}(\tau_{s_{t+1} : s_T} \mid s_t,a_t) \, d\tau_{s_{t+1} : s_T} =Q_{\pi_\theta} (s_t, a_t)
∇θJ(θ)=∑t=0T−1(∫(st,at)γt∇θlog⁡πθ(at∣st)Qπθ(st,at)πθ(at∣st)pθ(st) dst dat)=∑t=0T−1(Est∼pθ(st), at∼πθ(at∣st)[γt∇θlog⁡πθ(at∣st)Qπθ(st,at)])≈∑t=0T−1Est∼pθ(st), at∼πθ(at∣st)[∇θlog⁡πθ(at∣st)Qπθ(st,at)]\nabla_{\theta} J(\theta) = \sum_{t=0}^{T-1} \left( \int_{(s_t, a_t)} \gamma^{t} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) Q_{\pi_{\theta}}(s_t, a_t) \pi_{\theta}(a_t \mid s_t) p_{\theta}(s_t) \, ds_t \, da_t \right)\\ = \sum_{t=0}^{T-1} \left( \mathbb{E}_{s_t \sim p_{\theta}(s_t),\, a_t \sim \pi_{\theta}(a_t \mid s_t)} \left[ \gamma^{t} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) Q_{\pi_{\theta}}(s_t, a_t) \right] \right) \\ \approx \sum_{t=0}^{T-1} \mathbb{E}_{s_t \sim p_{\theta}(s_t),\, a_t \sim \pi_{\theta}(a_t \mid s_t)} \left[ \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) Q_{\pi_{\theta}}(s_t, a_t) \right]
•
Introduce the Baseline
◦
Replace the Q-function with an arbitrary function btb_t that is independent of the action.
∇θJ(θ)≈∑t=0T−1(∫(st,at)∇θlog⁡πθ(at∣st) bt πθ(at∣st)pθ(st) dst dat)=∑t=0T−1(∫st[∫at∇θπθ(at∣st) bt dat]pθ(st) dst)=∑t=0T−1(∫stbt[∫at∇θπθ(at∣st)dat]pθ(st) dst)\nabla_{\theta} J(\theta) \\ \approx \sum_{t=0}^{T-1} \left( \int_{(s_t, a_t)} \nabla_{\theta} \log \pi_{\theta}(a_t \mid s_t) \, b_t \, \pi_{\theta}(a_t \mid s_t) p_{\theta}(s_t) \, ds_t \, da_t \right) \\ = \sum_{t=0}^{T-1} \left( \int_{s_t} \left[ \int_{a_t} \nabla_{\theta} \pi_{\theta}(a_t \mid s_t) \, b_t \, da_t \right] p_{\theta}(s_t) \, ds_t \right) \\ = \sum_{t=0}^{T-1} \left( \int_{s_t} b_t \left[ \int_{a_t} \nabla_{\theta} \pi_{\theta}(a_t \mid s_t) da_t \right] p_{\theta}(s_t) \, ds_t \right)
◦
∫at∇θπθ(at∣st)dat=∇θ(1)=0\int_{a_t} \nabla_{\theta} \pi_{\theta}(a_t \mid s_t) da_t = \nabla_\theta (1) = 0
◦
Therefore, subtracting any baseline that is independent of the action from the Q-function does not affect the overall value of the equation.
∴∇θJ(θ)≈∑t=0T−1(Est∼pθ(st),at∼πθ(at∣st)[∇θ logπθ(at∣st)(Qπθ(st,at)−bt)])\therefore{\small \nabla_\theta J(\theta) \approx \sum_{t=0}^{T-1}(\mathbb{E}_{s_t \sim p_\theta(s_t), a_t \sim \pi_\theta(a_t|s_t)} [\nabla_\theta \ log \pi_\theta (a_t|s_t) (Q_{\pi_\theta} (s_t,a_t) - b_t)])}
◦
Aπθ(st,at)=Qπθ(st,at)−Vπθ(st,at)A_{\pi_\theta}(s_t, a_t) = Q_{\pi_\theta} (s_t, a_t) - V_{\pi_\theta} (s_t, a_t)
∴∇θJ(θ)≈∑t=0T−1(Est∼pθ(st),at∼πθ(at∣st)[∇θ logπθ(at∣st) Aπθ(st,at)])\therefore \nabla_\theta J(\theta) \approx \sum_{t=0}^{T-1}(\mathbb{E}_{s_t \sim p_\theta(s_t), a_t \sim \pi_\theta(a_t|s_t)} [\nabla_\theta \ log \pi_\theta (a_t|s_t) \ A_{\pi_\theta}(s_t, a_t) ])
◦
Aπθ(st,at)≈r(st,at)+γVπθ(st+1)−Vπθ(st)A_{\pi_\theta}(s_t, a_t) \approx r(s_t, a_t) + \gamma V_{\pi_\theta}(s_{t+1}) - V_{\pi_\theta}(s_{t})
∴∇θJ(θ)≈∑t=0T−1(Est∼pθ(st),at∼πθ(at∣st)[∇θ logπθ(at∣st) (r(st,at)+γVπθ(st+1)−Vπθ(st))]){ \small \therefore \nabla_\theta J(\theta) \approx \sum_{t=0}^{T-1}(\mathbb{E}_{s_t \sim p_\theta(s_t), a_t \sim \pi_\theta(a_t|s_t)} [\nabla_\theta \ log \pi_\theta (a_t|s_t) \ (r(s_t, a_t) + \gamma V_{\pi_\theta}(s_{t+1}) - V_{\pi_\theta}(s_{t}) )])}

3. Summary

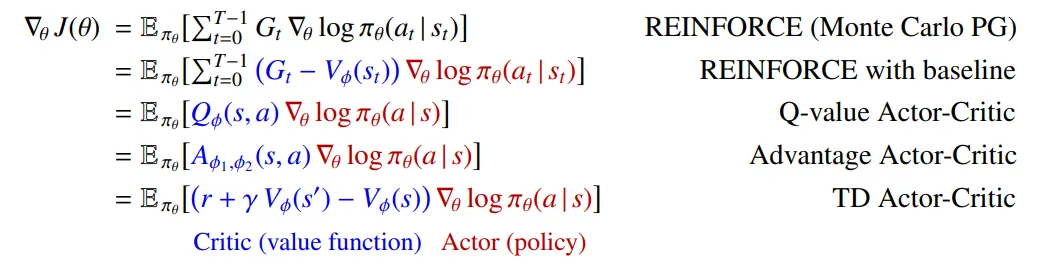
As a result, examining the form of each gradient shows that it consists of a product of two terms: one containing information about the direction in which the parameters should be optimized (∇θ\nabla_\theta), and another indicating how much the parameters should be updated in that direction. In practice, since it is difficult to directly compute the expectation over the entire trajectory, the sample mean is used as an approximation. The summation symbol (∑\sum) is omitted because, in many cases, online reinforcement learning updates the parameters immediately based on data generated from a single step.